มีข้อมูลอยู่แล้ว ไม่ได้แปลว่านำไปใช้ AI ได้เลย หลักการใช้ข้อมูลซ้ำ (Secondary Use) และความเสี่ยงด้าน Privacy
การนำข้อมูลเดิมมาใช้กับ AI (Secondary Use)
การที่องค์กรมีข้อมูลส่วนบุคคล (Personal Data) สะสมอยู่ในระบบอยู่แล้ว ไม่ได้หมายความว่าองค์กรจะมีสิทธิ์นำข้อมูลนั้นไป Train, Fine-tune, Profile หรือใช้ประมวลผลกับ AI ในวัตถุประสงค์ใหม่ได้ทันที การมีข้อมูลกับการมีฐานกฎหมาย (Lawful Basis) รองรับการประมวลผลรูปแบบใหม่เป็นคนละเรื่องกัน
แม้ข้อมูลจะถูกเก็บรวบรวมมาอย่างถูกต้องตามกฎหมาย PDPA ตั้งแต่แรก แต่เมื่อนำมาใช้กับเทคโนโลยี AI วัตถุประสงค์เดิม (Original Purpose) และระดับผลกระทบต่อเจ้าของข้อมูลอาจเปลี่ยนไป การประเมินความชอบด้วยกฎหมายและความเสี่ยงด้านความเป็นส่วนตัวจึงต้องเริ่มต้นใหม่เสมอ
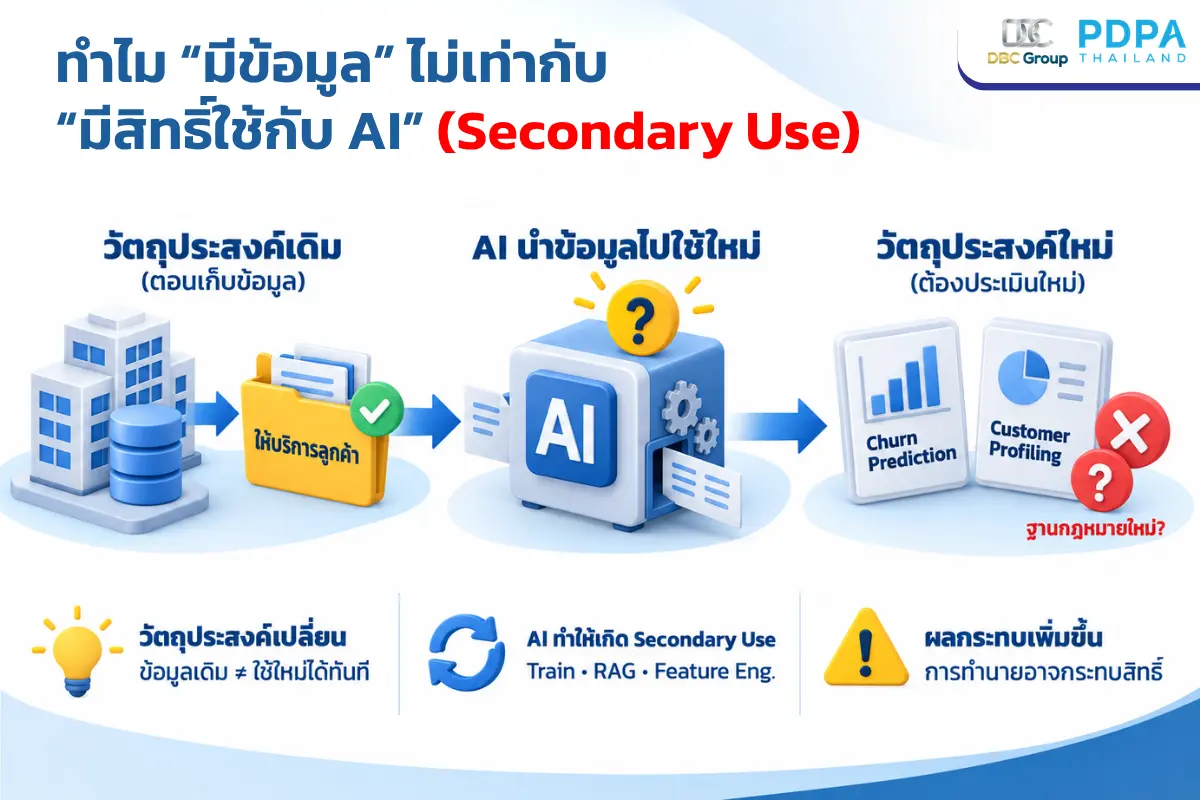
ทำไมคำว่า “ข้อมูลอยู่ในระบบเรา” ถึงใช้เป็นเหตุผลทางกฎหมายไม่ได้
องค์กรจำนวนมากมักคุ้นเคยกับการนำชุดข้อมูลเดิมที่มีอยู่มาทดลองใช้กับ AI เช่น การนำประวัติการติดต่อของฝ่ายบริการลูกค้า (Customer Service) ไปใช้วิเคราะห์โอกาสการยกเลิกบริการ (Churn Prediction) หรือสร้างโปรไฟล์ลูกค้า (Customer Profiling) โดยให้เหตุผลว่าข้อมูลเป็นขององค์กรอยู่แล้ว
ในมุมมองด้าน Data Protection เหตุผลนี้ไม่เพียงพอด้วยปัจจัยดังนี้
- วัตถุประสงค์เปลี่ยน (Purpose Limitation) ข้อมูลที่เก็บเพื่อการให้บริการอย่างหนึ่ง ไม่สามารถนำไปใช้เพื่อการวิเคราะห์หรือทำนายผลอีกอย่างหนึ่งได้โดยอัตโนมัติ
- AI ทำให้เกิด Secondary Use ง่ายขึ้น เทคโนโลยี AI ช่วยให้ข้อมูลชุดเดิมถูกนำไปใช้ซ้ำในหลายรูปแบบ เช่น การทำ Embedding, RAG, Feature Engineering ไปจนถึงการ Train Model ซึ่งทุกกิจกรรมนับเป็นการประมวลผลใหม่
- ระดับผลกระทบเพิ่มขึ้น การนำข้อมูลไปประเมินหรือทำนายพฤติกรรม สร้างผลกระทบต่อสิทธิ์และโอกาสของเจ้าของข้อมูลมากกว่าการเก็บรักษาข้อมูลไว้เฉยๆ
Lawful Basis และความเข้าใจผิดเกี่ยวกับ Consent ในงาน AI
การพิจารณาฐานทางกฎหมาย (Lawful Basis) ในการประมวลผลข้อมูลด้วย AI มักมีความเข้าใจผิดสองรูปแบบหลัก คือ การคิดว่าต้องขอความยินยอม (Consent) ใหม่ทุกครั้ง หรือการคิดว่าสามารถใช้ฐานประโยชน์โดยชอบด้วยกฎหมาย (Legitimate Interest) ครอบคลุมได้ทั้งหมด
การเลือก Lawful Basis ที่ถูกต้อง ต้องพิจารณาจากกิจกรรมการประมวลผล (Processing Activity) เป็นหลัก
กิจกรรมประมวลผล | ตัวอย่างการใช้งาน | ข้อควรพิจารณาทางกฎหมาย |
Primary Use | ใช้ AI สรุปข้อมูลเพื่อให้บริการตามสัญญาเดิม | อาจใช้ฐานการปฏิบัติตามสัญญา (Contract) ได้ |
Model Improvement | นำข้อมูลลูกค้าไป Train หรือ Fine-tune Model | ต้องพิจารณาว่าเข้าข่าย Secondary Use หรือไม่ อาจต้องใช้ Legitimate Interest หรือ Consent |
Profiling & Prediction | ใช้ AI สร้าง Score เพื่อตัดสินใจให้สิทธิ์/อนุมัติ | ต้องประเมินความคาดหมายของเจ้าของข้อมูล และอาจต้องมีการประเมินผลกระทบ (DPIA) |
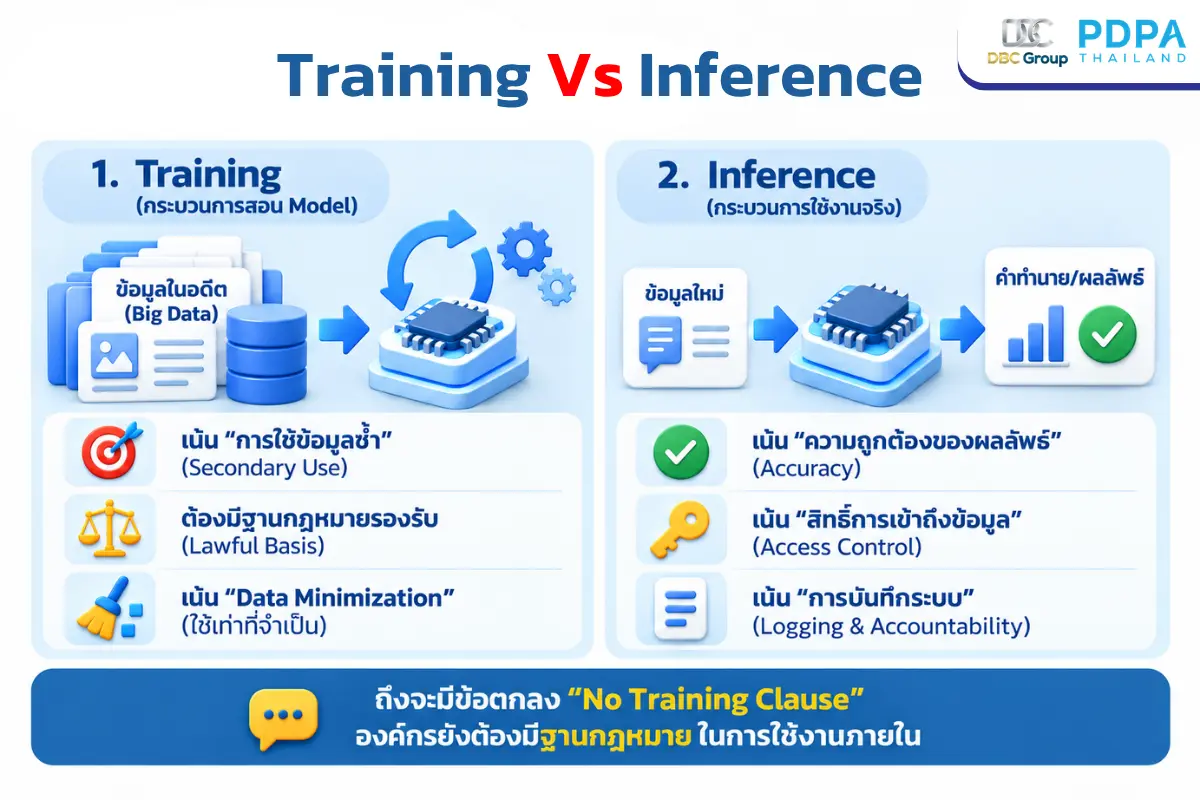
ข้อแตกต่างระหว่าง Training กับ Inference ในมุมมอง Data Privacy
ความเข้าใจผิดเรื่องขอบเขตการใช้ข้อมูล มักเกิดจากการไม่แยกแยะระหว่างกระบวนการพัฒนาและการนำไปใช้งานจริง
- Training / Model Improvement คือการนำข้อมูลย้อนหลังจำนวนมากไปปรับแต่งหรือสอนให้ AI เรียนรู้ กระบวนการนี้เน้นเรื่องการนำข้อมูลไปใช้ซ้ำ (Secondary Use) และการทำ Data Minimization
- Inference คือการส่งข้อมูลเข้าสู่โมเดลเพื่อสร้างผลลัพธ์ในแต่ละครั้ง กระบวนการนี้เน้นเรื่องความถูกต้องของผลลัพธ์ (Accuracy) สิทธิ์การเข้าถึง (Access Control) และการบันทึกระบบ (Logging)
ข้อความระบุว่า “ผู้ให้บริการไม่นำข้อมูลไป Train Model” (No Training Clause) ช่วยสร้างความมั่นใจเรื่องข้อมูลรั่วไหลไปสู่ Vendor แต่ไม่ได้หมายความว่าองค์กรจะมีสิทธิ์นำข้อมูลนั้นมาใช้ประมวลผลภายในองค์กรโดยไม่ต้องมีฐานกฎหมายรองรับ
Inferred Data ข้อมูลอนุมานใหม่ที่มาพร้อมความเสี่ยง
เมื่อ AI ประมวลผลข้อมูลเดิม ระบบมักจะสร้างข้อมูลชุดใหม่ขึ้นมา เรียกว่า Inferred Data เช่น คะแนนความเสี่ยง (Risk Score) ระดับความสนใจ หรืออันดับความเหมาะสมของผู้สมัครงาน
แม้เจ้าของข้อมูลจะไม่ได้เป็นผู้ให้ข้อมูลเหล่านี้โดยตรง แต่เมื่อข้อมูลจากการอนุมานสามารถระบุตัวบุคคลได้ จะถือเป็นข้อมูลส่วนบุคคลทันที องค์กรจึงต้องทบทวนประเด็นสำคัญต่อไปนี้
- ความคาดหมายที่เหมาะสม (Reasonable Expectations) เจ้าของข้อมูลคาดคิดหรือไม่ว่าข้อมูลของตนจะถูกนำไปใช้อนุมานเรื่องดังกล่าว
- ความโปร่งใส (Transparency) องค์กรได้แจ้งให้เจ้าของข้อมูลทราบผ่าน Privacy Notice หรือไม่ว่ามีการสร้างข้อมูลอนุมาน
- อคติและความแม่นยำ (Bias & Accuracy) ผลลัพธ์จากการอนุมานมีความแม่นยำเพียงพอหรือไม่ก่อนนำไปใช้ตัดสินใจ
Lawfulness ไม่ได้แปลว่า Low Risk
การมีฐานกฎหมายรองรับ (Lawfulness) เป็นเพียงเงื่อนไขขั้นต่ำในการประมวลผลข้อมูล แต่ไม่ได้หมายความว่าระบบ AI นั้นจะมีความเสี่ยงต่ำ (Low Risk) ในทางกลับกัน Use Case ที่มีความเสี่ยงต่ำ ก็ยังจำเป็นต้องมีฐานกฎหมายรองรับเช่นกัน
องค์กรจึงควรแยกการประเมินออกเป็น 2 ชั้นเสมอ
- ชั้นที่ 1 Legal Review กิจกรรมการประมวลผลนี้มีวัตถุประสงค์ชัดเจน และมีฐานกฎหมายรองรับหรือไม่
- ชั้นที่ 2 Risk & Impact Review ต่อให้มีฐานกฎหมายแล้ว กระบวนการนี้สร้างผลกระทบต่อบุคคลเพียงใด จำเป็นต้องมีมาตรการควบคุม (Controls) การทำ Legitimate Interest Assessment (LIA) หรือ Data Protection Impact Assessment (DPIA)เพิ่มเติมหรือไม่
ไม่จำเป็นต้องขอ Consent ใหม่เสมอไป หากองค์กรสามารถใช้ฐานประโยชน์โดยชอบด้วยกฎหมาย (Legitimate Interest) ได้ ทั้งนี้ต้องทำการประเมิน LIA เพื่อพิสูจน์ว่าประโยชน์ขององค์กรไม่ละเมิดสิทธิขั้นพื้นฐานของเจ้าของข้อมูล และต้องมีช่องทางให้ปฏิเสธ (Opt-out) ได้
ยังไม่เพียงพอ เงื่อนไข "No Training" เป็นเพียงการยืนยันว่าผู้ให้บริการภายนอกจะไม่นำข้อมูลไปพัฒนาโมเดลของตนเอง แต่ไม่ได้ตอบโจทย์เรื่องฐานกฎหมายในการใช้งานขององค์กร ระยะเวลาการเก็บรักษา Log หรือสิทธิในการประมวลผลข้อมูลปลายทาง
ถือเป็นข้อมูลส่วนบุคคล หากข้อมูลที่วิเคราะห์หรืออนุมานขึ้นมาใหม่นั้น สามารถเชื่อมโยงกลับไประบุตัวตนของบุคคลนั้นๆ ได้ และมีผลกระทบต่อการตัดสินใจเกี่ยวกับตัวบุคคล
สรุป
หลักการสำคัญของการใช้ข้อมูลกับ AI คือ Having data ≠ automatic right to reuse with AI และ Lawfulness ≠ Low Risk การมีข้อมูลอยู่ในระบบไม่ได้ให้สิทธิ์ในการนำไปใช้ซ้ำโดยอัตโนมัติ และการมีฐานกฎหมายก็ไม่ได้แปลว่าระบบไร้ความเสี่ยง องค์กรจึงต้องประเมินวัตถุประสงค์เดิมเทียบกับวัตถุประสงค์ใหม่ และแยกแยะกิจกรรมการประมวลผลให้ชัดเจน เพื่อให้การใช้ AI เกิดประโยชน์สูงสุดควบคู่ไปกับการคุ้มครองสิทธิของเจ้าของข้อมูล
อยากนำ AI มาใช้ในองค์กร แต่ยังกังวลเรื่องความปลอดภัยและข้อมูลรั่วไหล?
หลักสูตร “Privacy in AI Era” ช่วยควบคุมความเสี่ยง AI สู่การลงมือทำจริงในสายงานของคุณ
เผยแพร่: 14 กันยายน 2569
อัปเดตล่าสุด: 14 กันยายน 2569
ช่องทางติดต่อ:
Facebook: PDPA Thailand
Line OA: @pdpathailand
Email: [email protected]
Website: www.pdpathailand.com