DPIA ของ AI ต้องมอง Harm ต่อคน ไม่ใช่แค่ Cyber Risk สรุปวิธีประเมินผลกระทบให้ถูกต้องตาม PDPA
การประเมินผลกระทบด้านการคุ้มครองข้อมูลส่วนบุคคลสำหรับการใช้ AI
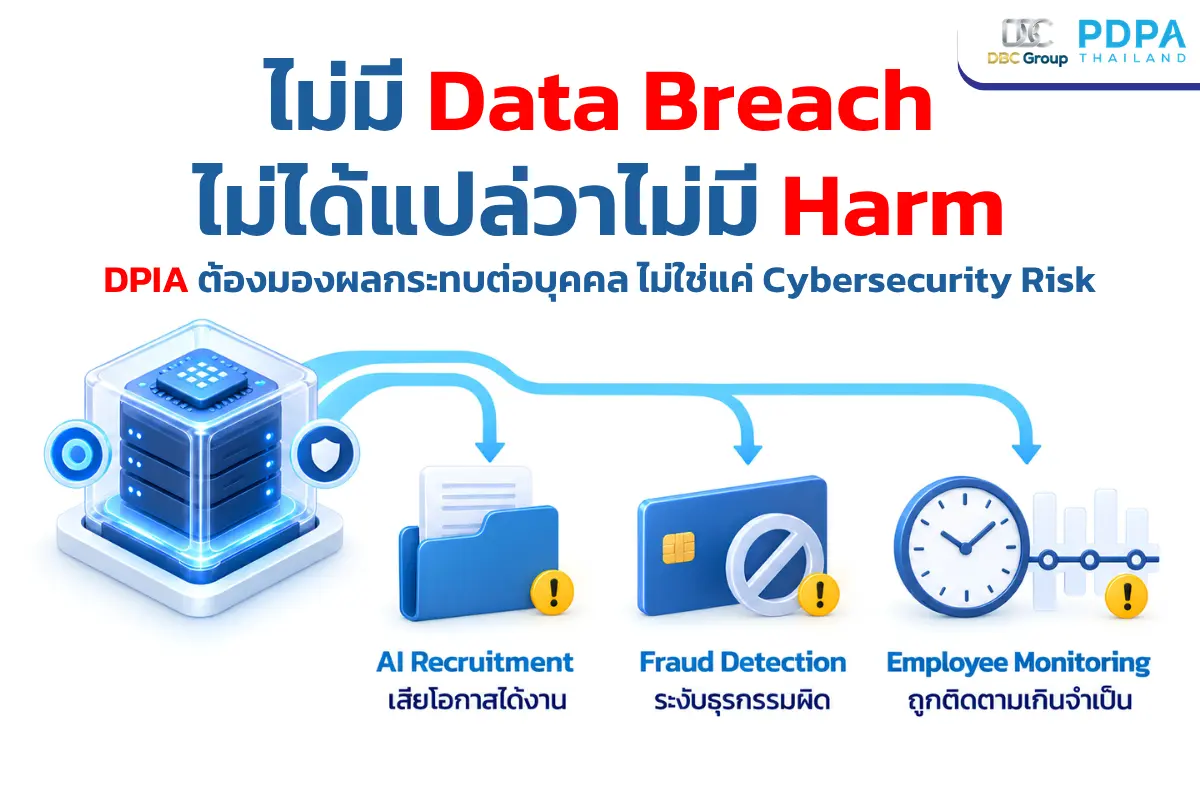
การประเมินผลกระทบด้านการคุ้มครองข้อมูลส่วนบุคคล (Data Protection Impact Assessment: DPIA) สำหรับระบบ AI ไม่ควรถือเป็นเพียงแบบตรวจสอบความปลอดภัยทางไซเบอร์ (Cybersecurity Checklist) เพราะความเสียหายหรือผลกระทบอันไม่พึงประสงค์ (Harm) ที่เกิดขึ้นกับเจ้าของข้อมูลส่วนบุคคล สามารถเกิดขึ้นได้แม้ระบบ AI จะทำงานอย่างถูกต้องตามที่ได้รับการออกแบบไว้ และไม่มีเหตุการณ์ข้อมูลรั่วไหล (Data Breach) เกิดขึ้นเลยแม้แต่ครั้งเดียว
การประเมิน DPIA ที่ดีตามกฎหมาย PDPA จึงต้องมุ่งวิเคราะห์ไปที่ผลกระทบและอันตรายที่อาจเกิดขึ้นกับบุคคลธรรมดา (Individual Harm) ไม่ใช่จำกัดอยู่แค่การป้องกันภัยคุกคามทางเทคนิคในเชิงองค์กรเพียงอย่างเดียว
ทำไม DPIA ของ AI ถึงไม่ใช่แค่เรื่อง Cybersecurity Risk
ในการประเมินความเสี่ยงทั่วไป องค์กรมักมุ่งเน้นไปที่การเข้ารหัสข้อมูล (Encryption) การควบคุมสิทธิ์การเข้าถึง (Access Control) และการป้องกันช่องโหว่ของระบบ (Vulnerability Management) ซึ่งถือเป็นมาตรการที่จำเป็น แต่ยังไม่ครอบคลุมความเสี่ยงด้านความเป็นส่วนตัว (Privacy Risk) ในยุค AI
ระบบ AI ที่ปลอดภัยจากการถูกแฮก ยังคงสามารถสร้างผลกระทบเชิงลบต่อบุคคลได้ในหลายลักษณะ เช่น
- AI Recruitment ระบบประเมินผู้สมัครงานผิดพลาดด้วยข้อมูลที่ไม่แม่นยำ ทำให้ผู้สมัครเสียโอกาสในการได้งาน
- Fraud Detection Model ระบบตรวจจับการทุจริตระงับทำธุรกรรมของลูกค้าอย่างไม่เป็นธรรม (False Positive)
- Employee Monitoring ระบบติดตามการทำงานของพนักงานสร้างสภาวะความกดดัน และละเมิดสิทธิความเป็นส่วนตัวเกินความจำเป็น
เหตุการณ์เหล่านี้เกิดขึ้นได้โดยไม่มีเหตุการณ์ Data Breach หรือ Cyber Attack แม้แต่ครั้งเดียว การมอง DPIA เป็นเพียงเรื่อง Cyber Risk จึงทำให้องค์กรตกสำรวจความเสี่ยงสำคัญไป
ขั้นตอนการประเมิน DPIA สำหรับ AI ให้ครอบคลุมทุกมิติ
เพื่อการประเมินที่ตรงจุดและมีประสิทธิภาพ องค์กรควรดำเนินกระบวนการ DPIA ตามลำดับขั้นตอน ดังนี้
1. เริ่มจาก Processing Activity และ Data Flow
ก่อนการจัดทำรายการความเสี่ยง (Risk Register) ต้องทำความเข้าใจธรรมชาติ ขอบเขต บริบท และวัตถุประสงค์ของการประมวลผล รวมทั้งเขียนเส้นทางการไหลของข้อมูล (Data Flow Mapping) ให้ชัดเจน ตั้งแต่ Data Source -> Collection -> Use -> Inference -> Output -> Sharing -> Retention -> Deletion
2. เขียน Risk Statement ที่ระบุ Harm ต่อบุคคล
การระบุคำว่า “Model Bias”, “Data Breach” หรือ “AI Hallucination” ยังไม่ใช่ Risk Statement ที่สมบูรณ์ โครงสร้างการระบุความเสี่ยงที่ดีควรอิงตามหลักการ
{Event/Cause (เหตุการณ์/สาเหตุ) -> Affected Person (ผู้ได้รับผลกระทบ) -> Harm to Individual (ความเสียหายต่อบุคคล)
- ตัวอย่างที่ถูกต้อง AI ประเมินผลคะแนนผู้สมัครผิดพลาดจากข้อมูลย้อนหลังที่ไม่ครอบคลุม (Cause) ส่งผลให้ผู้สมัครกลุ่มเฉพาะ (Affected Person) ถูกลดอันดับและสูญเสียโอกาสในการได้รับการคัดเลือกอย่างไม่เป็นธรรม (Harm)
3. ประเมิน Necessity และ Proportionality ก่อนใส่ Controls
ก่อนจะรีบใส่มาตรการควบคุมความเสี่ยง (Controls) ให้ตั้งคำถามกับโครงสร้างการออกแบบระบบก่อนว่ามีความจำเป็นและได้สัดส่วนหรือไม่ เช่น
- ข้อมูลทุกประเภทที่นำเข้าสู่ AI มีความจำเป็นจริงหรือไม่
- สามารถลดระยะเวลาจัดเก็บข้อมูลให้สั้นลงได้หรือไม่
- จำเป็นต้องใช้ AI ในกระบวนการนี้จริง หรือการใช้เงื่อนไขแบบ Rule-based ก็เพียงพอแล้ว
4. ประเมิน Initial Risk สู่ Residual Risk ด้วย Evidence
การให้คะแนนโอกาสเกิด (Likelihood) และระดับความรุนแรง (Severity) ต้องมีหลักฐานเชิงประจักษ์ (Evidence) และบริบทประกอบ จากนั้นจึงเลือกมาตรการควบคุมที่ตรงกับสาเหตุของความเสี่ยงจริง เช่น การใช้ Encryption ช่วยลดความเสี่ยงจากการเข้าถึงโดยไม่ได้รับอนุญาตได้ แต่ไม่สามารถลดอคติของแบบจำลอง (Model Bias) ได้
เมื่อใช้มาตรการควบคุมแล้ว ต้องประเมินความเสี่ยงที่เหลืออยู่ (Residual Risk) อีกครั้ง หากความเสี่ยงยังคงอยู่ในระดับสูง ต้องจัดทำมาตรการยกระดับการตัดสินใจ (Escalation) ต่อไป
การใช้ AI Risk Layers ร่วมกับ DPIA
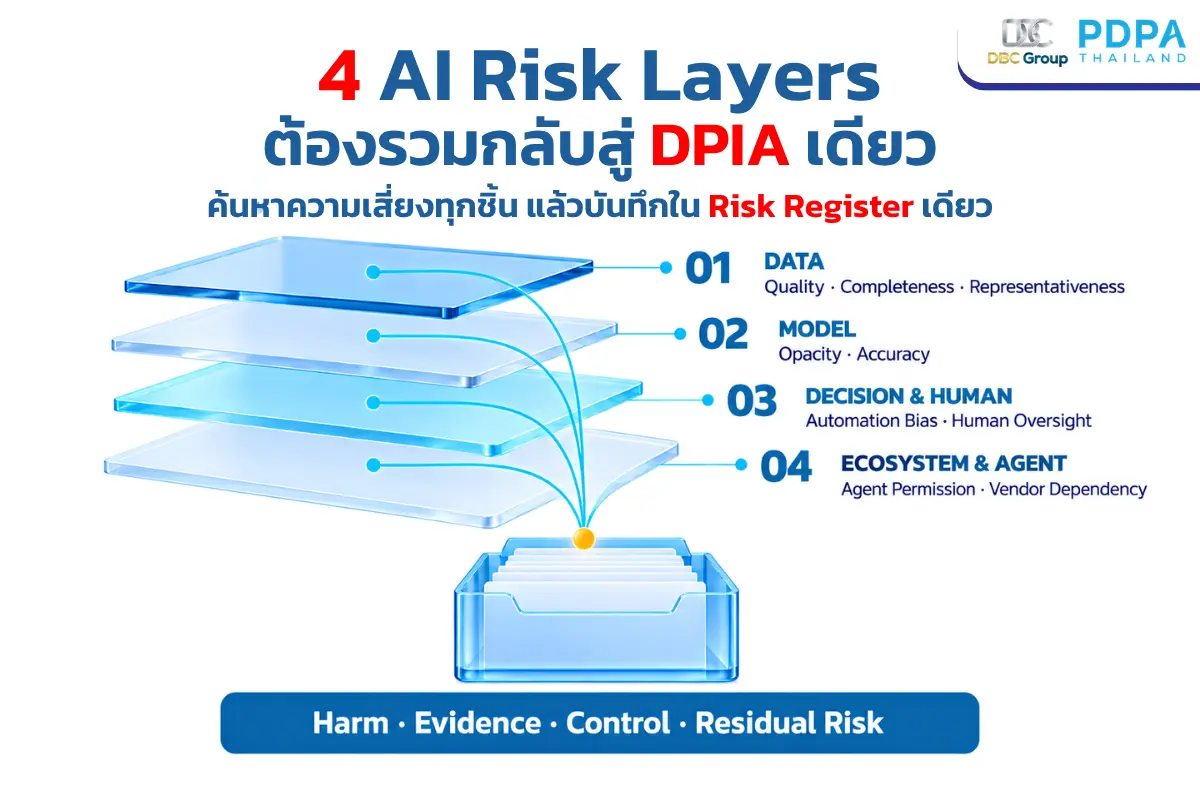
ระบบ AI เพิ่มชั้นความเสี่ยงที่ซับซ้อนกว่าระบบไอทีทั่วไป องค์กรสามารถใช้ AI Risk Layers Canvas เข้ามาช่วยค้นหาความเสี่ยงในมิติต่างๆ เพื่อให้ครอบคลุมรอบด้าน
- Data Layer คุณภาพข้อมูล ความครบถ้วน และความเป็นตัวแทนของข้อมูล (Representativeness)
- Model Layer ความโปร่งใสของอัลกอริทึม (Opacity) และความแม่นยำ
- Decision & Human Layer การมีอคติจากการพึ่งพา AI (Automation Bias) และระดับการกำกับดูแลโดยมนุษย์ (Human Oversight)
- Ecosystem & Agent Layer สิทธิ์การทำงานของ AI Agent และการพึ่งพาผู้ให้บริการภายนอก (Vendor Dependency)
เมื่อค้นพบประเด็นความเสี่ยงจาก AI Risk Layers แล้ว ให้นำข้อสังเกตทั้งหมดกลับเข้ามาบันทึกไว้ใน DPIA Risk Register เดียวกัน พร้อมทั้งระบุ Harm, Evidence, Control และ Residual Risk ให้ครบถ้วน เพื่อไม่ให้เกิดการแยกเอกสารการประเมินจนขาดความเชื่อมโยง
Cybersecurity Risk Assessment เน้นการปกป้องระบบและข้อมูลจากการถูกโจมตี ข้อมูลรั่วไหล หรือความเสียหายต่อองค์กร ส่วน DPIA ตาม PDPA เน้นประเมินผลกระทบ ความเสียหาย และการละเมิดสิทธิที่อาจเกิดขึ้นต่อตัวบุคคลธรรมดาผู้เป็นเจ้าของข้อมูล
ไม่จริง เพราะ AI สามารถสร้างผลกระทบต่อบุคคลได้ผ่านกระบวนการประมวลผล เช่น การอนุมานผลผิดพลาด การประเมินผลที่มีอคติ หรือการตัดสินใจที่ไม่เป็นธรรม ซึ่งก่อให้เกิดความเสียหายต่อสิทธิและโอกาสของบุคคลได้แม้ระบบจะมีความปลอดภัยสูงก็ตาม
ไม่จำเป็น ควรกำหนดขอบเขตการประเมิน DPIA แยกตาม Use Case หรือตามกิจกรรมการประมวลผล (Processing Activity) ที่ชัดเจน เพื่อให้สามารถระบุเส้นทางข้อมูล เหตุการณ์ความเสี่ยง และมาตรการควบคุมได้อย่างแม่นยำ
สรุป
คำถามสำคัญของการทำ DPIA สำหรับ AI ไม่ใช่เพียงแค่ “ระบบจะถูกเจาะหรือไม่” แต่คือ “แม้ระบบจะทำงานได้ตามที่ออกแบบไว้ บุคคลอาจได้รับผลกระทบหรือความเสียหายอย่างไร” การปรับเปลี่ยนมุมมองจากการปกป้ององค์กรมาเป็นการปกป้องสิทธิและประโยชน์ของเจ้าของข้อมูล จะช่วยให้การทำ DPIA มีประสิทธิภาพ สอดคล้องกับกฎหมาย PDPA และสร้างความน่าเชื่อถือในการใช้ AI อย่างยั่งยืน
อยากนำ AI มาใช้ในองค์กร แต่ยังกังวลเรื่องความปลอดภัยและข้อมูลรั่วไหล?
หลักสูตร “Privacy in AI Era” ช่วยควบคุมความเสี่ยง AI สู่การลงมือทำจริงในสายงานของคุณ
เผยแพร่: 16 กันยายน 2569
อัปเดตล่าสุด: 16 กันยายน 2569
ช่องทางติดต่อ:
Facebook: PDPA Thailand
Line OA: @pdpathailand
Email: [email protected]
Website: www.pdpathailand.com